累積で並べると、なぜ詰まらないのか
保存ランキングサイトの多くは、保存された総数で並べている。総数は 投稿が古いほど大きくなる。つまり後から伸び始めた作品は、 どれだけ勢いがあっても上位に来られない。
実際に同じ投稿群を2つの基準で並べると、顔ぶれが変わる。 累積では埋もれていた投稿が、速度では上位に入る。
累積(既存の並べ方)
- 1,919 挨拶投稿
- 527 入部して?
- 121 注意書き付き告知
- 99 コンビニ深夜バイト
- 94 作品告知
速度(Elontirの並べ方)
- 54.7/h 挨拶投稿
- 8.9/h 入部して?
- 8.1/h 新作パッケージ
- 6.6/h 新人デビュー
- 5.9/h 注意書き付き告知
3位と4位は累積44位相当から浮上した投稿。
グラフを辿って、検索に頼らない
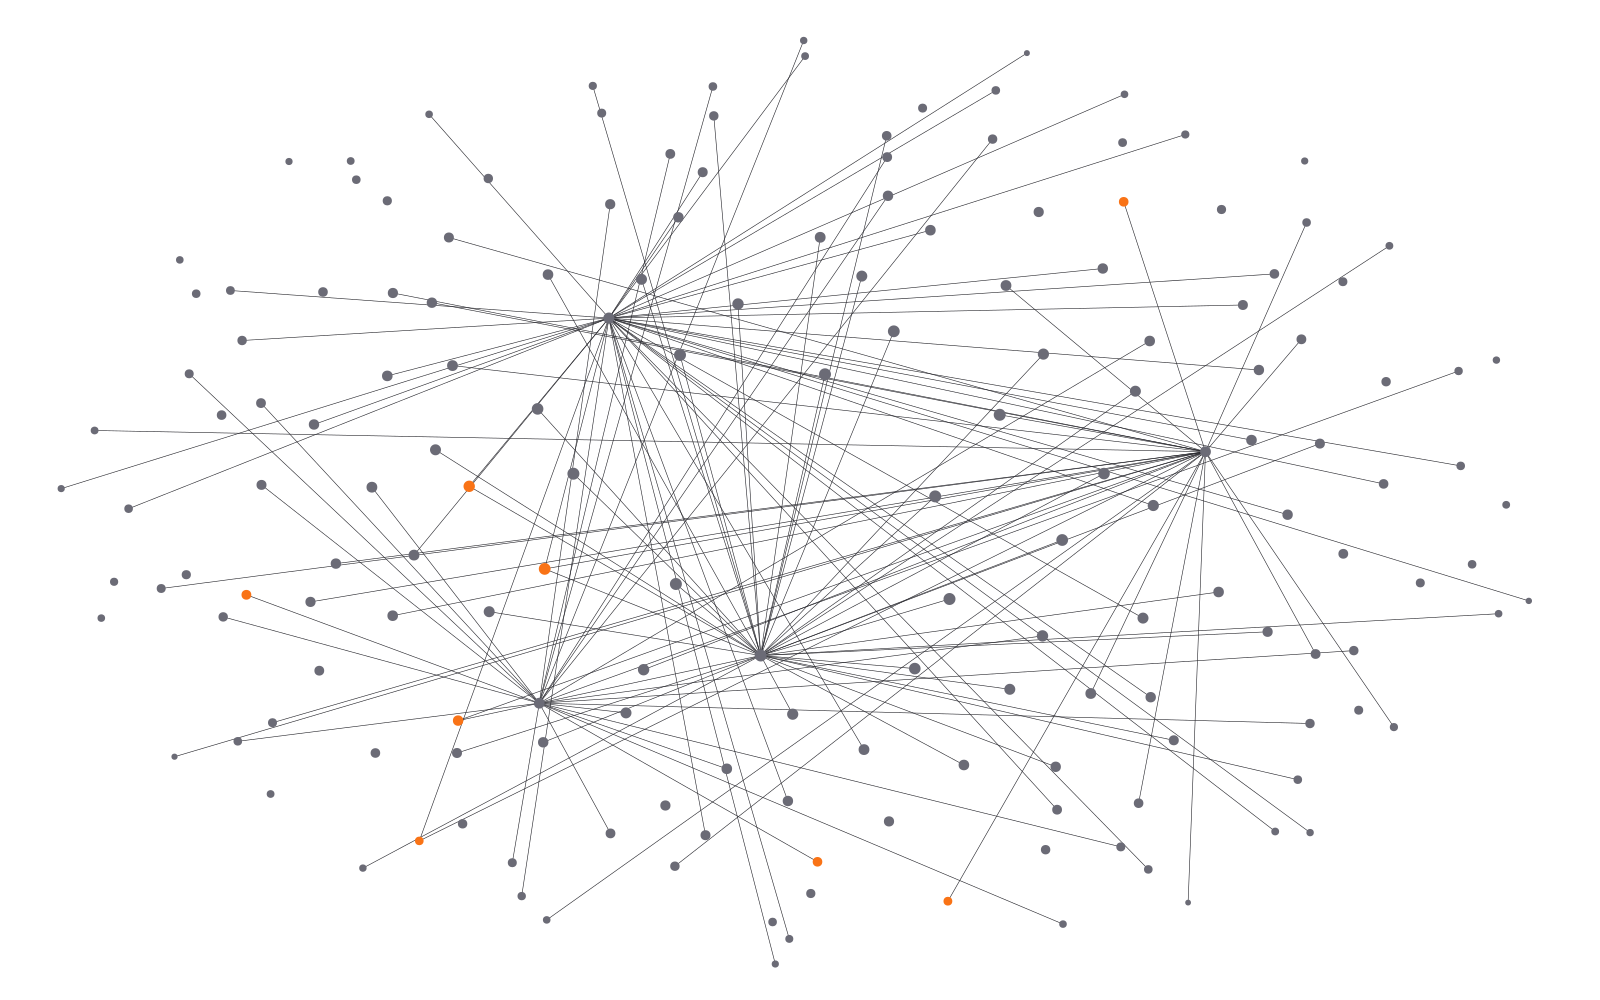
本文検索が使えない環境でも、1つの手掛かりアカウントから辺を辿れば 探索範囲は広がる。フォロー関係、拡散、関連候補の3種類の辺を使う。
-
種から辺を辿る
フォローグラフを幅優先で辿る。複数のルートから到達したノードは 関連が強いと判断して優先する。1つの種から257ノードまで広がった。
-
無関係なノードを落とす
フォロワー数上位には企業・自治体・ゲームなどが混ざる。LLMで 関連と無関係を分類し、グラフの骨格を業界ノードだけにする。
-
速度と加速度で採点する
保存・リポスト・いいねを別々に測り、単位時間あたりの増加で並べる。 30分ごとに同じ投稿を観測し、速度が立ち上がった瞬間を捉える。
-
新顔だけを出す
累積がまだ小さいのに速度が高い投稿を「新顔」として抽出する。 これが既存ランキングでは出てこない発見になる。
実測で確かめたこと
推測ではなく、実行して得た数字だけを載せている。
シグナル別に伸び幅を測る
保存・リポスト・いいねは性質が違う。同じ数でも意味が違うため、 別々に測って重みを分けている。
- リポストは最も早く動く
- 22分の観測で、リポストは1時間あたり66件のペースで動いた。保存は 同じ投稿で0件。伸び始めを最速で捉える指標はリポストになる。
- 拡散型と保存型は別物
- 同じ22分でも、保存0・リポスト66/hの投稿と、保存5.5/h・リポスト30/hの 投稿が並ぶ。前者は拡散、後者は支持。分けて見ることで性質が読める。
- 累積÷経過時間より、観測の差分
- 伸び幅は前回観測との差分から計算する。累積を経過時間で割る方式は 平均値なので、今まさに立ち上がった瞬間を見逃す。
実装中に見つけた欠陥と対処
- 投稿直後の速度が過大評価される
- 投稿から6分の時点で保存1件でも「10/h」と計算され、実際に伸びている 投稿より上位に来ていた。速度の分母に下限を置いて解決。
- 挨拶投稿が1位になる
- 動画も画像もない投稿が速度1位を占めた。メディアの有無でフィルタし、 ない投稿は減点するようにした。
- 判定が途中で空になる
- 推論にトークンを消費するモデルでは、上限が小さいと本文が空で返る。 上限を上げ、思考ログから結果を救済する処理を入れた。
作っている人間について
この仕組みは、過去に保存ランキングサイトを運営していた経験から来ている。 当時は他サイトの集計を読む形で作っていたため、相手が対策を打つと 止まる構造だった。数字も自分のものではなかった。
同じ問題を、今度は一次データから解き直している。Xの投稿から直接 保存数を取り、グラフ探索で発見し、速度で並べる。集計は自分の手元に 蓄積される。
- 保存ランキング型メディアの運営経験
- 複数ドメインでの漫画メディア運営経験
- カメラ・映像・ソフトウェアの実機検証と発信
- AIエージェントによる収集・判定・監視の自動化